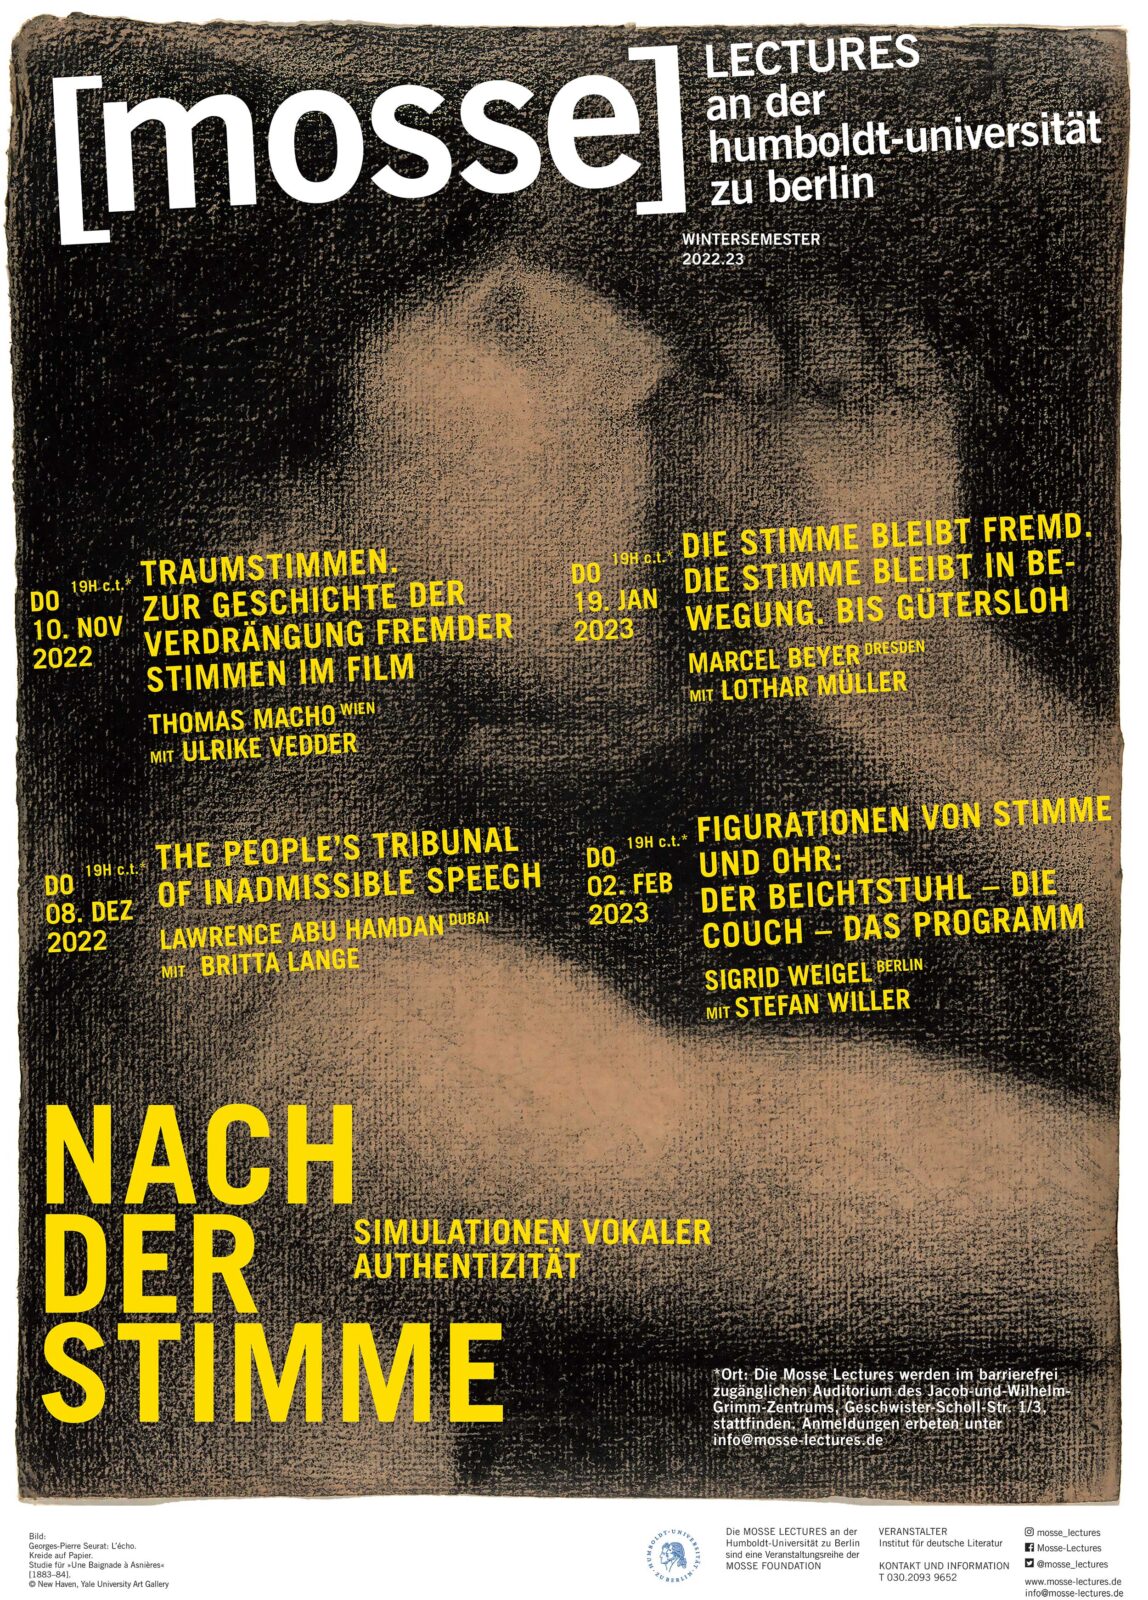
2023: Sigrid Weigel, “Figurationen von Stimme und Ohr: der Beichtstuhl – die Couch – das Programm” / “Figurations of Voice and Ear: The Confessional, the Couch, the Program”
Sigrid Weigel, “Figurationen von Stimme und Ohr: der Beichtstuhl – die Couch – das Programm” / “Figurations of Voice and Ear: The Confessional, the Couch, the Program”
Humboldt University Berlin Mosse Lecture
mosselectures.wisc.edu/berlin/
Thursday, 2 February 2023, 19:15 CET
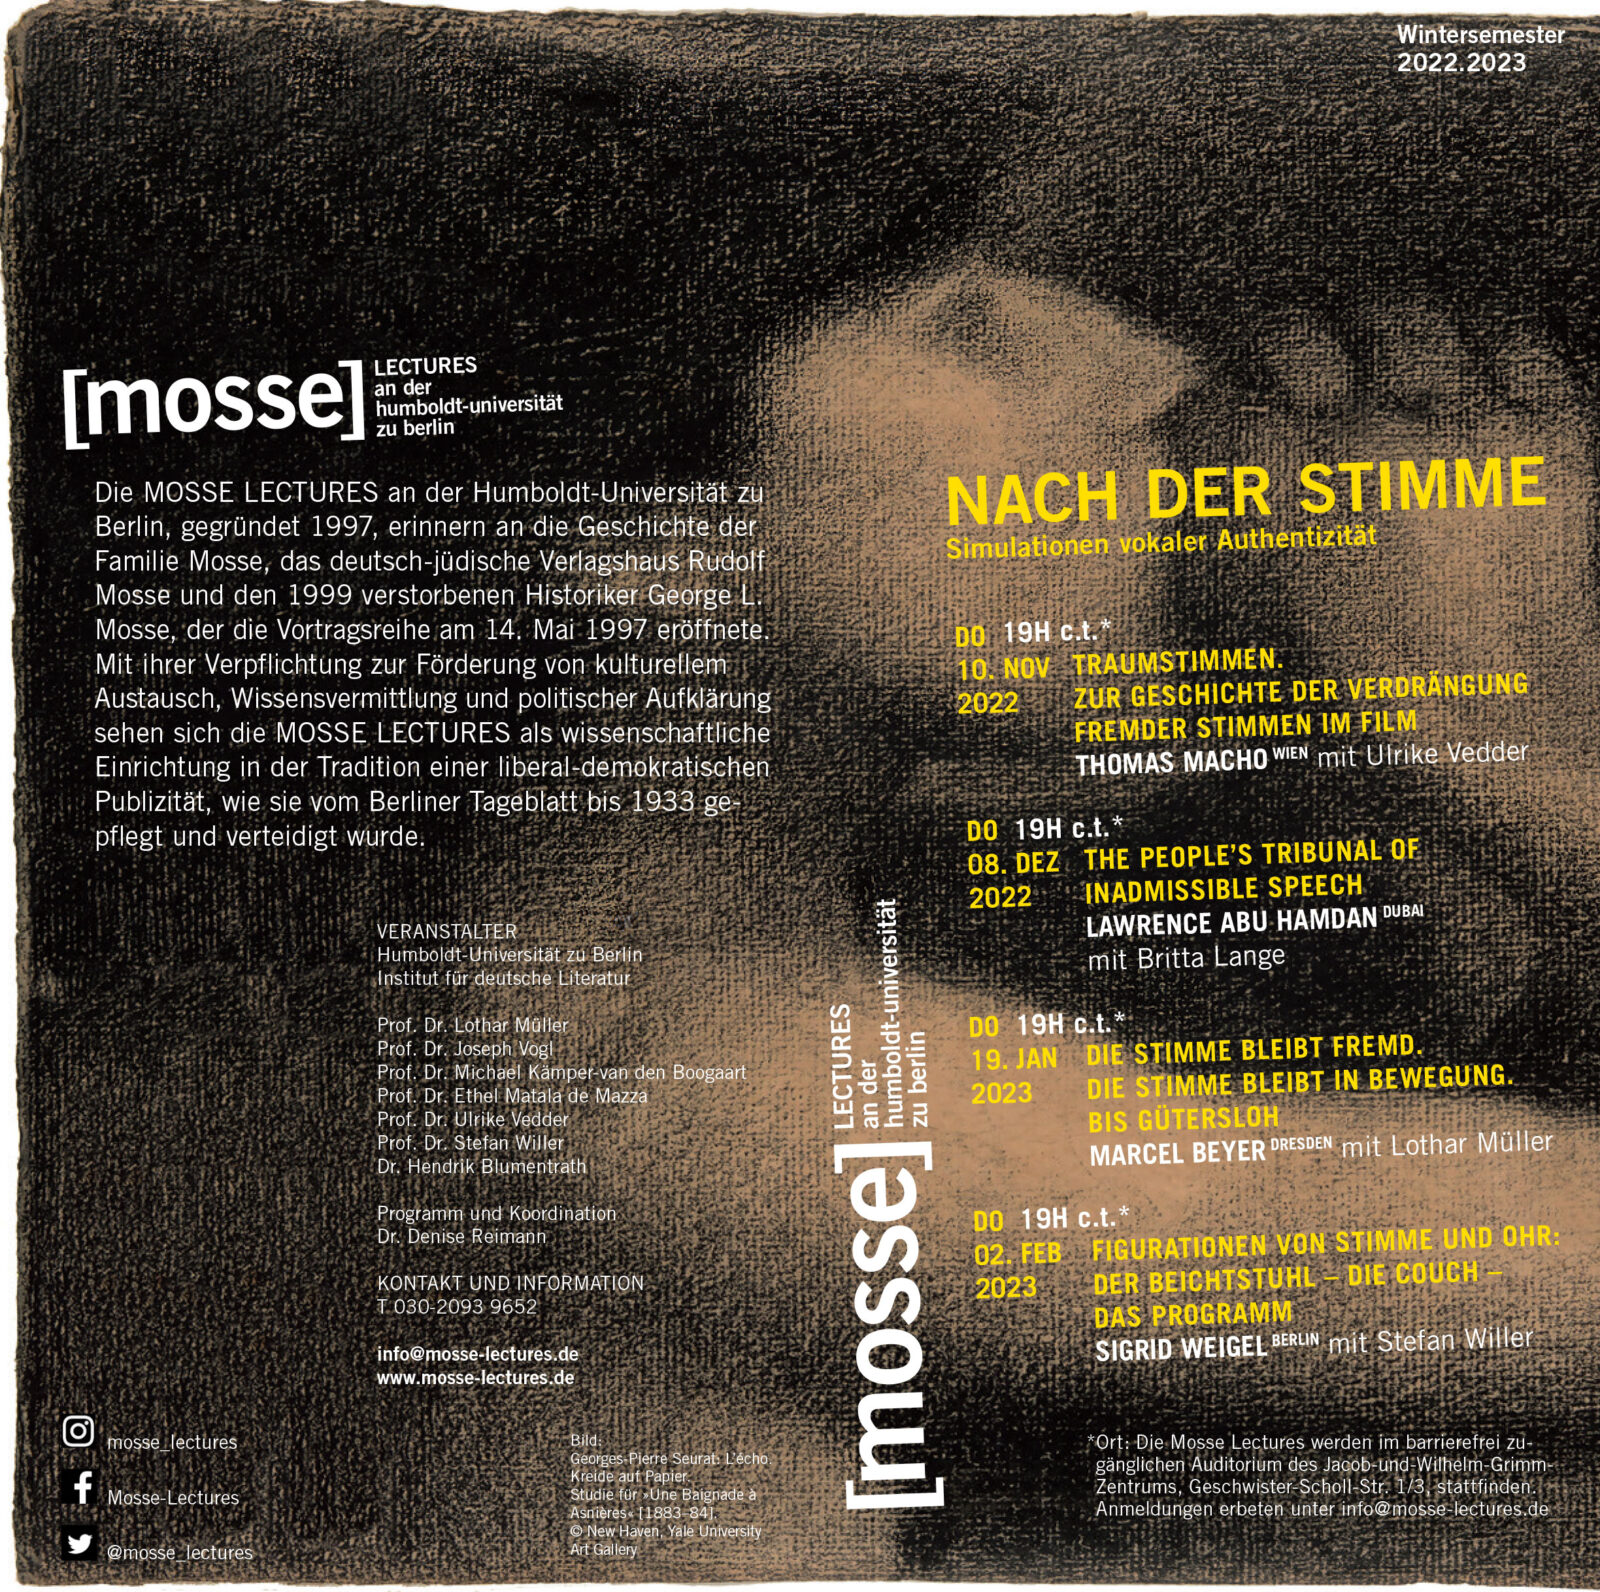
Auditorium of Jacob-und-Wilhelm-Grimm-Zentrum
Geschwister-Scholl-Str. 1/3
10117 Berlin
GERMANY
Sponsored by:
[mosse] LECTURES an der humboldt-universität zu berlin
The Mosse Foundation
Global Mosse Lecture Series
Institut für deutsche Literatur
Humboldt University
Moderator: Stefan Willer (Humboldt University)
Lecture Description: Ein wechselweises Sprechen und Hören in der Gegenwart zweier Personen von Angesicht zu Angesicht: das gilt als idealtypische Gesprächssituation. Dagegen ist die Konstellation von Stimme und Ohr signifikant asymmetrisch. Obwohl die Aktivität bei der/dem Sprechenden liegt, gebietet das Ohr über die Rede. Dessen Ort und Instanz entscheiden über die Art des Hörens – erhören, zuhören, anhören, lauschen, verhören, aushorchen – und weisen den Betenden, Pönitenten, Patienten, Zeugen oder Delinquenten den ihnen angemessenen Sprechakt zu. Die Hoffnung, ein geneigtes Ohr zu finden, oder die Verheißung, ge- oder erhört zu werden, fordern eine Unterwerfung unter die Autorität oder das Wissen der hörenden Instanz. Deren Macht ist nicht selten mit einer symptomatischen Unsichtbarkeit verbunden: ganz Ohr, aber ohne (sichtbaren) Körper, – wie auf antiken Weihtafeln und Ohrenstelen für ‚erhörende Götter‘ zu sehen. Wenn menschliche Instanzen in dieses Szenario eintreten, bleiben sie oft verborgen, z.B. hinter dem Gitter des Beichtstuhls, im Rücken des Patienten in der Analyse, am anderen Ende der medialen Leitung. Diese Verborgenheit wird in der digitalen Stimmanalyse, bei der Algorithmen zur Sprecheridentifikation und Emotion Detection eingesetzt werden, total.
Lecture Series Theme: “Nach der Stimme. Simulationen vokaler Authentizität”‘/”The Digital Voice. Simulations of Vocal Authenticity”
Lectures Series Description: Die Stimme gilt – neben Gesicht, Fingerabdruck und DNA – als untrüglicher Ausweis der Identität und Singularität eines Individuums. Vor Gericht werden Tonaufnahmen als beweiskräftiges Spurenmaterial herangezogen. In den (sozialen) Medien wird die Stimme eingesetzt, um für die Authentizität der Sprecher:innen zu bürgen. Ihre einzigartige Prosodie, ihre spontane, ephemere und brüchige Performanz erzeugen eine Nähe und Intimität, mit denen selbst das Gesicht nicht mithalten kann. In Zeiten von Fake News und einer permanent sich aufdrängenden effekthascherischen Bilderwelt verspricht die Stimme Unverfälschtheit, Nahbarkeit und Tiefe. Die Dimension der Tiefe beanspruchen derweil auch jene Software-Programme für sich, die das Authentizitätsversprechen der Stimme in ihren Grundfesten erschüttern: Mit KI-generierten Deep Fake Voices können Stimmen „geklont“ und Personen Sätze in den Mund gelegt werden, die sie niemals gesagt haben. Die Mosse Lectures wollen einerseits nach den historischen Vorläufern und ästhetischen Vorwegnahmen jener digitalen Stimmsimulationen fragen: An welche Geschichte der Stimm- und Sprachsynthese knüpfen Deep Fake Voices an und wie wurden sie erzählerisch antizipiert – von Johannes Keplers Traum einer künstlich imitierbaren Stimme (Somnium sive astronomia lunaris, 1634) bis hin zu Andres Veiels Fernsehfilm Ökozid (2020), einem Vorausblick auf die politischen Folgen manipulierter Stimm- und Videoaufzeichnungen? Der Blick zurück offenbart das enorme poetische Potential der Stimmsimulation, das nicht zuletzt auch die Geschichte der Gesangs- und Schauspielkunst entscheidend geprägt hat. Andererseits gilt es perspektivisch die Konsequenzen jener Entwicklungen zu diskutieren. Inwiefern können Deep Fake Voices jenen ihre Stimme zurückgeben, die sie durch Krankheit oder Unfall verloren haben? Welche poetologischen und urheberrechtlichen Fragen werfen die Aneignung und Neuzusammensetzung von Stimmen auf? Welche juristischen Implikationen sind mit der schwindenden Zuverlässigkeit der Stimme als Beweismaterial verbunden? Wie verhalten sich digital simulierte Stimmen zu aktuellen emotionspsychologischen Befunden, die Stimme könne weniger gut lügen als das Gesicht? Was macht es mit uns, wenn wir der Stimme nicht (mehr) trauen können – in alltäglichen Kommunikationssituationen, aber auch in politischen Zusammenhängen?
Along with the face, fingerprints and DNA, the voice is considered unmistakable proof of the identity and singularity of an individual and is used under certain conditions in court and sound recordings as evidence. The voice is also used in (social) media to authenticate the speaker. Its unique prosody and spontaneous, ephemeral and fragile performance create a closeness and intimacy that even the face cannot match. In times of fake news, but also of a permanently imposing, gimmicky world of images in which the manipulation of visual media has long since become standard, the voice promises closeness, authenticity and depth. The software programs that have been shaking the very foundations of the voice’s promise of authenticity for some years now also work with the dimension of depth. Deep Fake Voices can be used to put sentences into people’s mouths that they have never said. For one thing, the Mosse Lectures want to ask about the historical precursors and aesthetic anticipations of those digital voice simulations. What history of voice and speech synthesis do Deep Fake Voices tie into and how were they narratively anticipated – from Johannes Kepler’s dream of an artificially imitable voice (Somnium sive astronomia lunaris, 1634) to Andres Veiel’s Ökozid (2020), a cinematic foresight into the political consequences of manipulated voice and video recordings? A look back reveals the enormous poetic potential of voice simulation, which has also had a decisive influence on the history of the art of singing and acting. Furthermore, it is important to discuss the consequences of the current developments in voice simulation. To what extent can Deep Fake Voices give their voice back to those who have lost it, for example through illness or accident? What copyright issues do the appropriation and recomposition of voices raise? What are the legal implications of the diminishing reliability of the voice as evidence and the use of Deep Fake Voices for criminal purposes? How do digitally simulated voices relate to current findings in emotional psychology that the voice is less capable of lying than the face? What does it do to us when we can no longer trust the voice – in everyday communication situations, but also in political contexts?
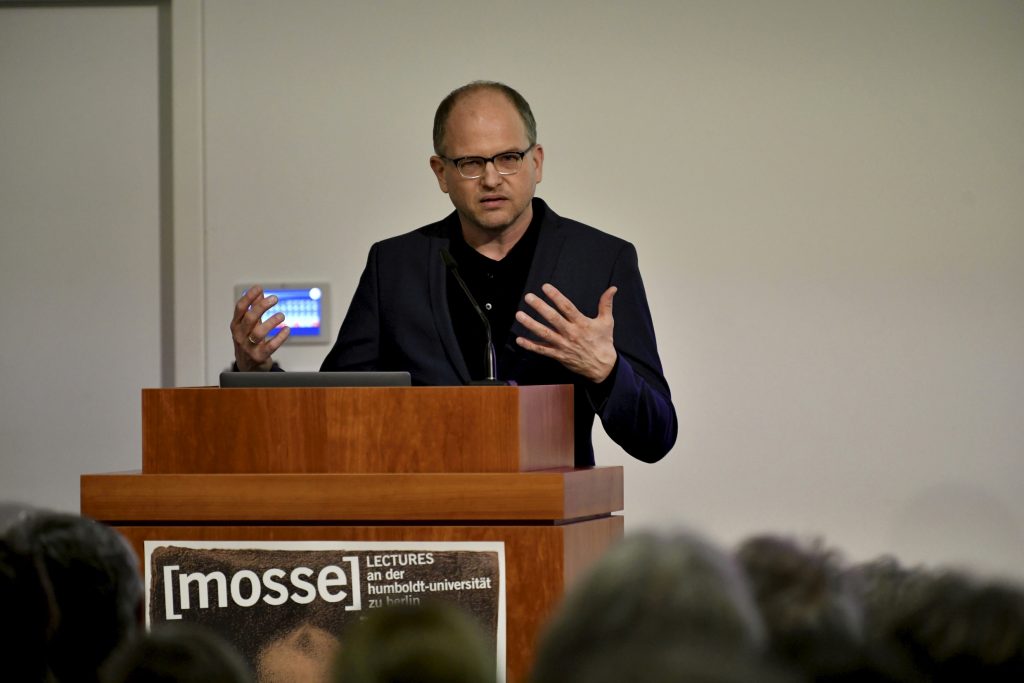
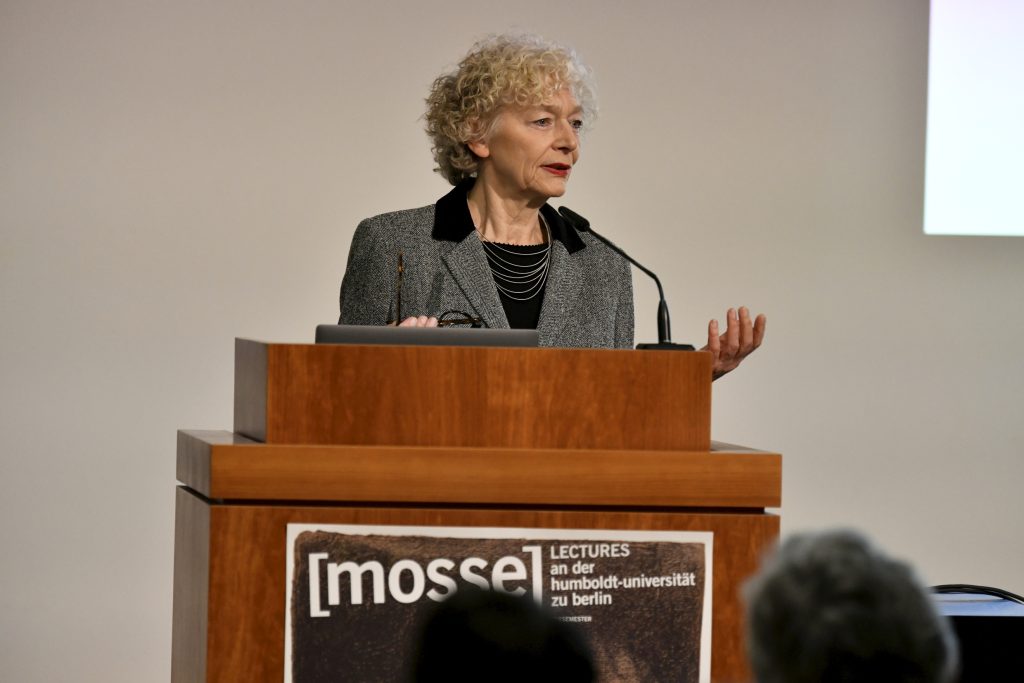
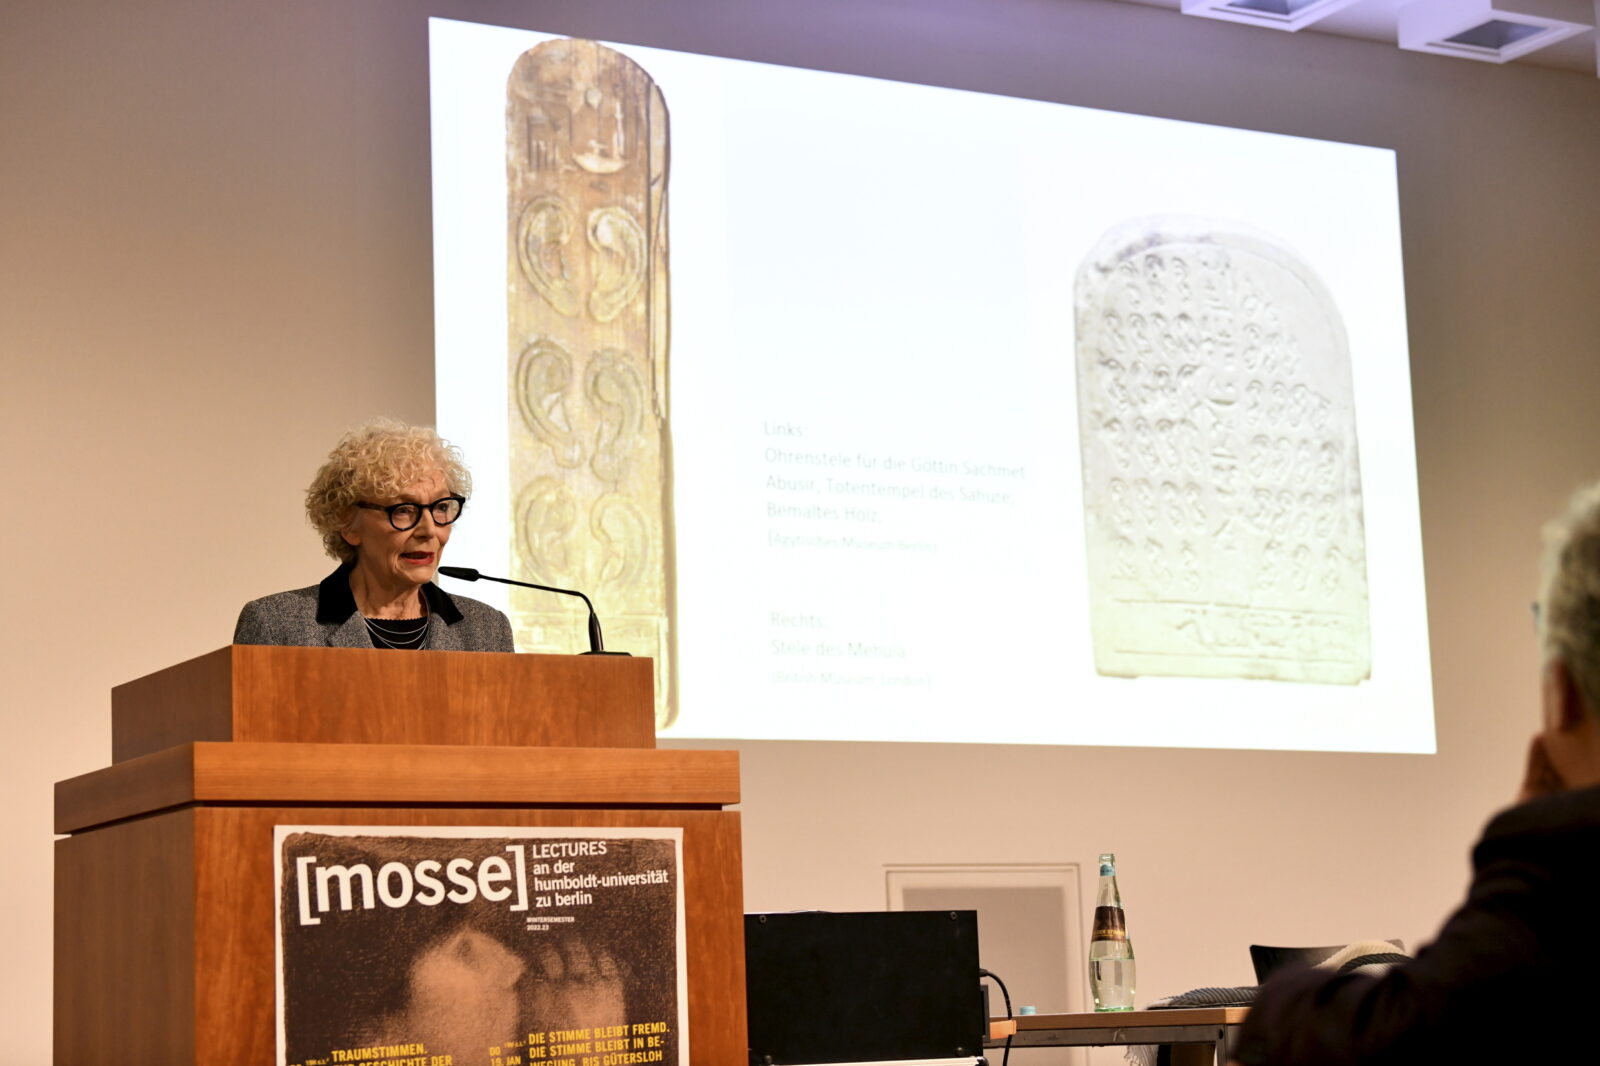
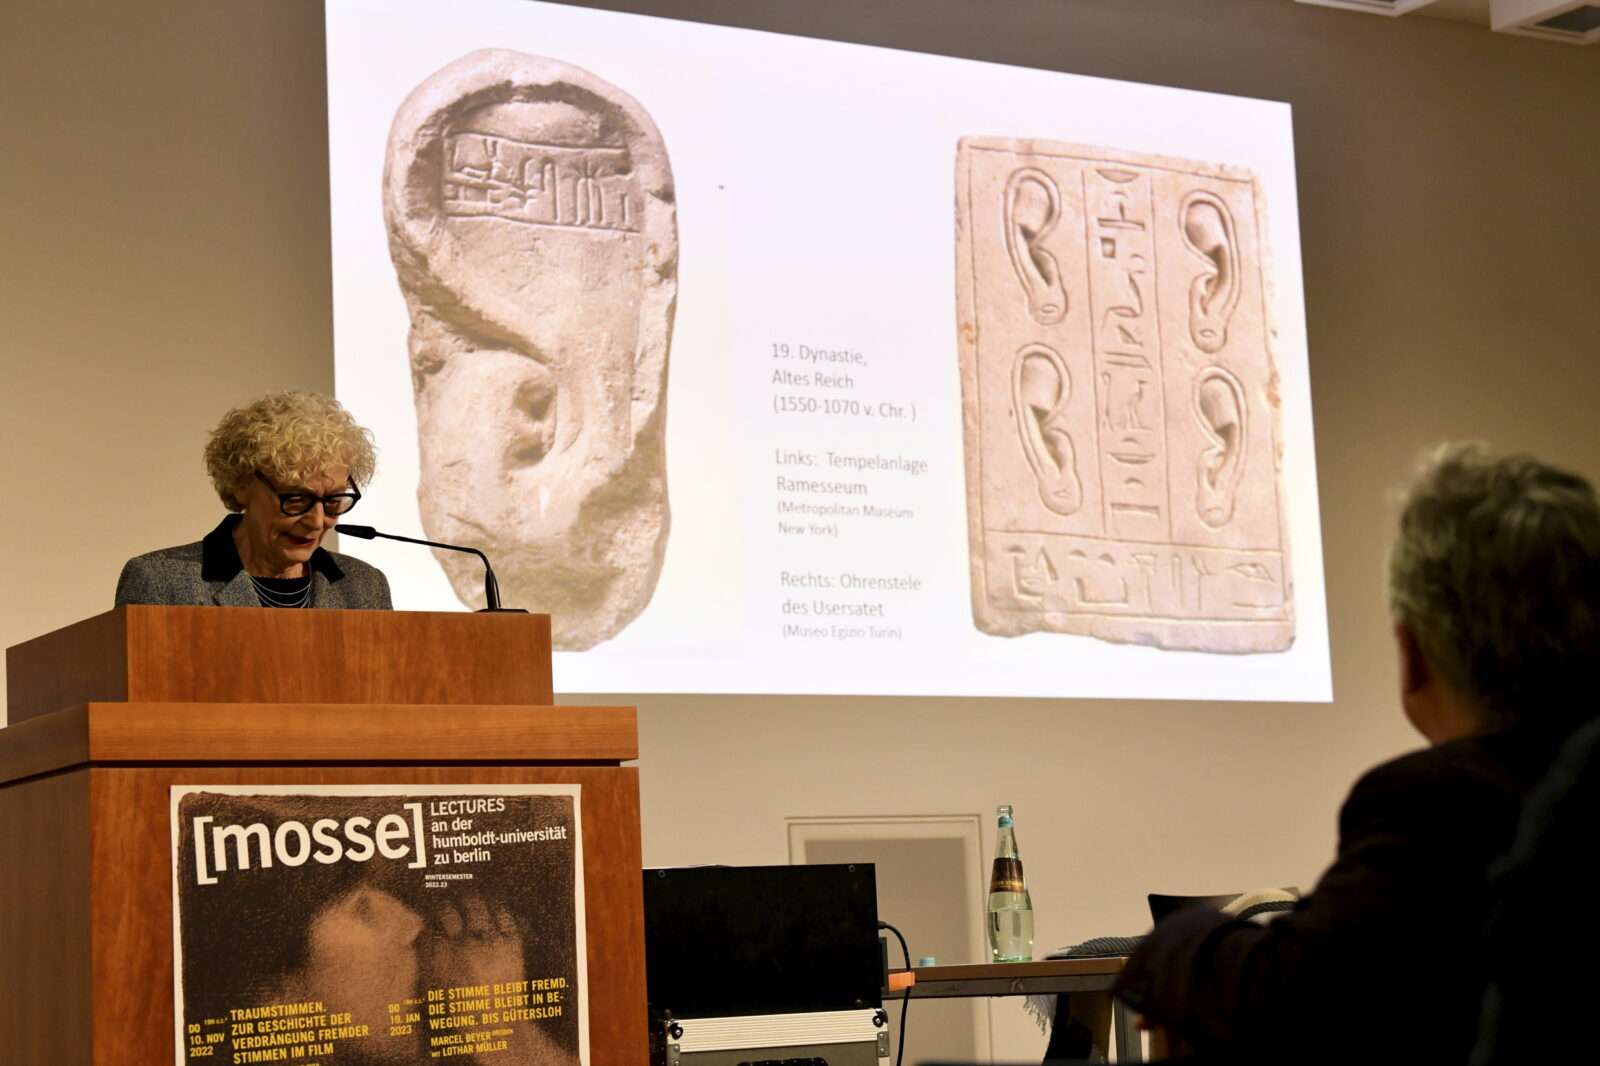
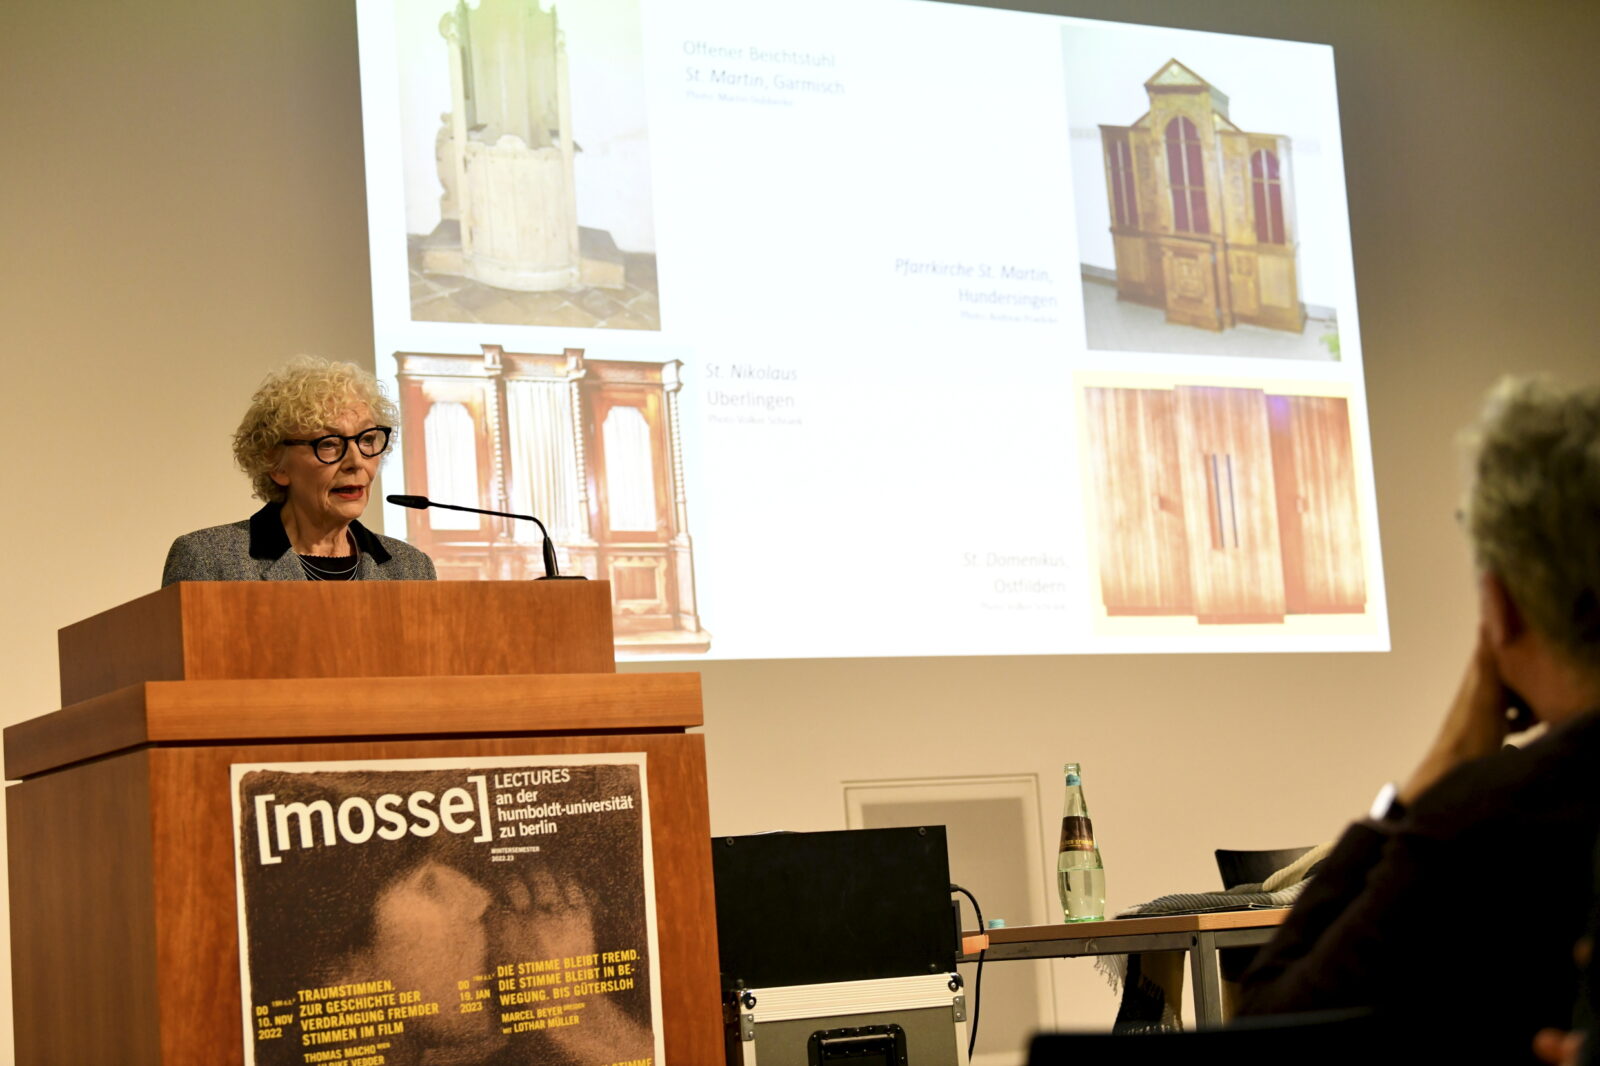
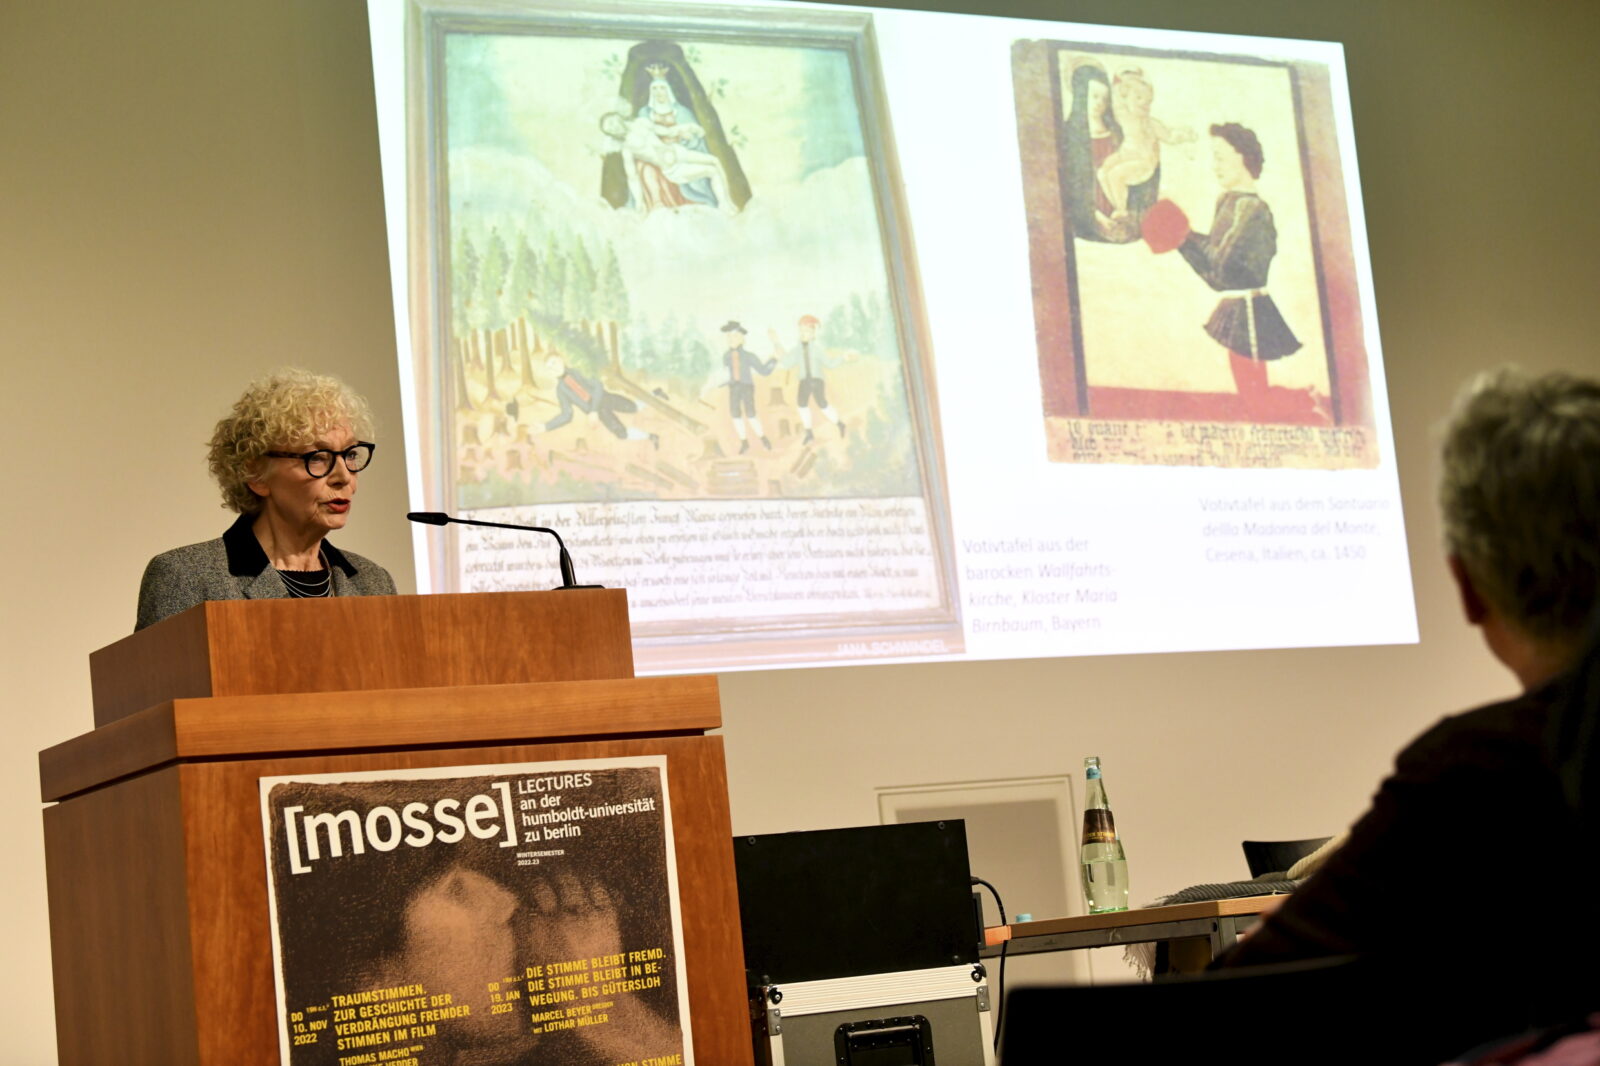
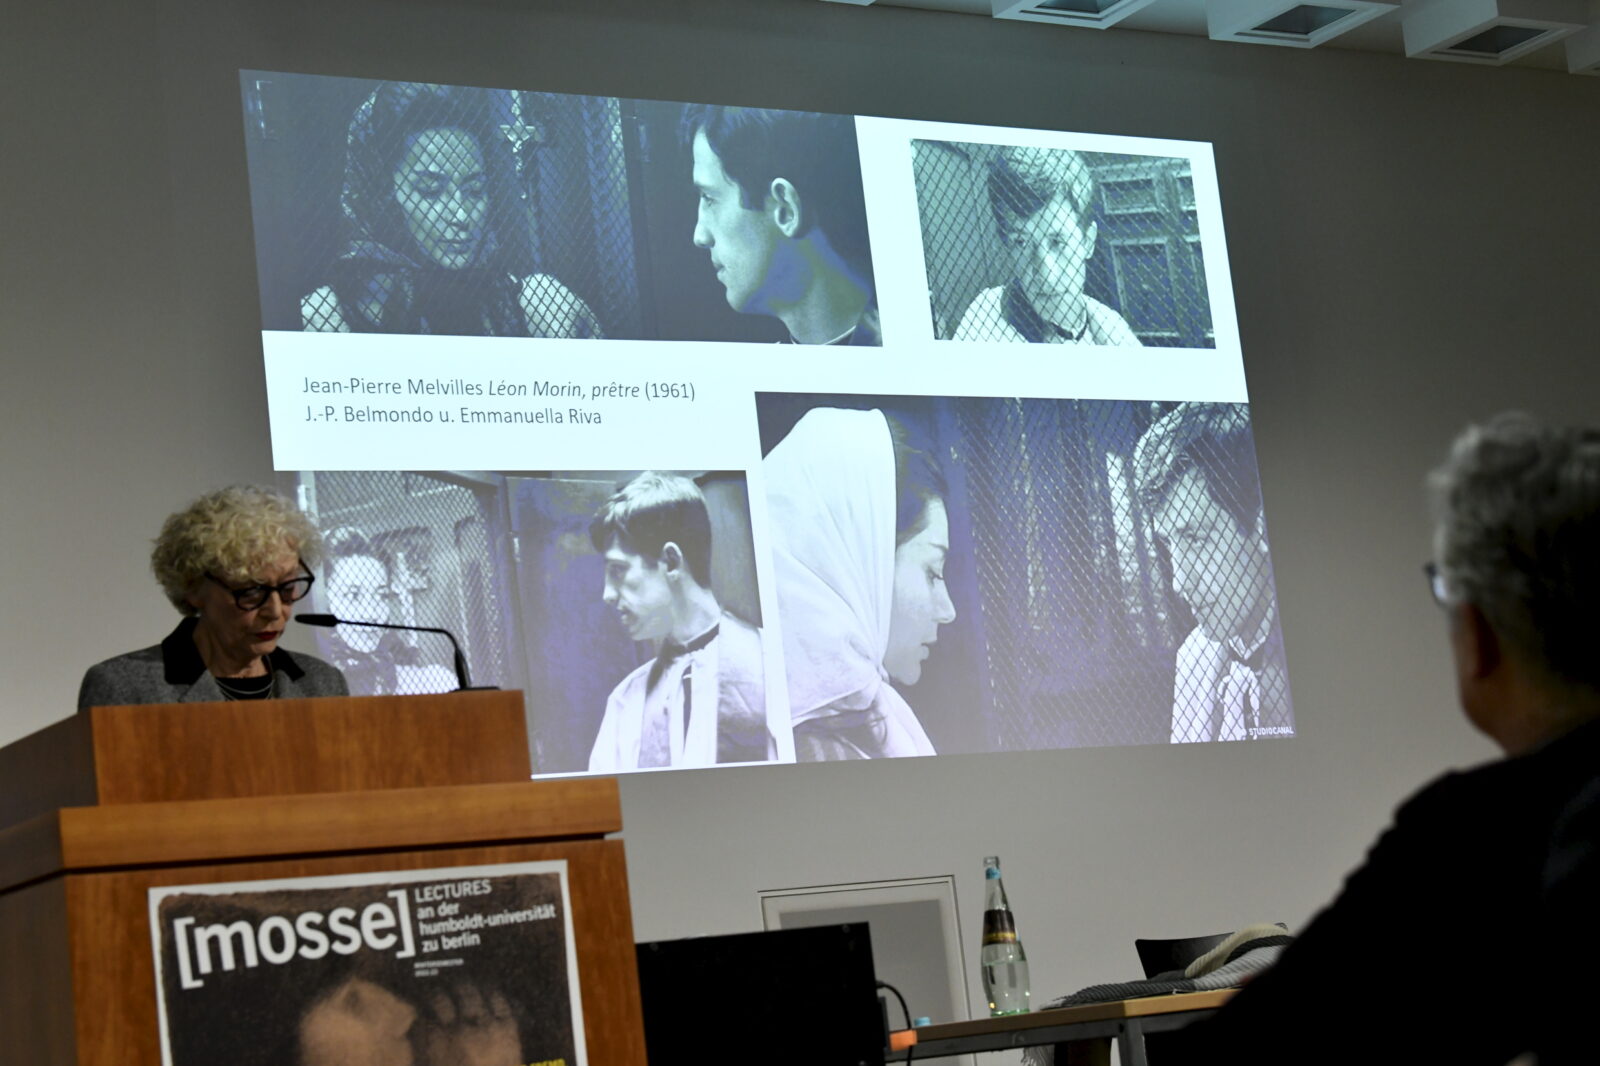
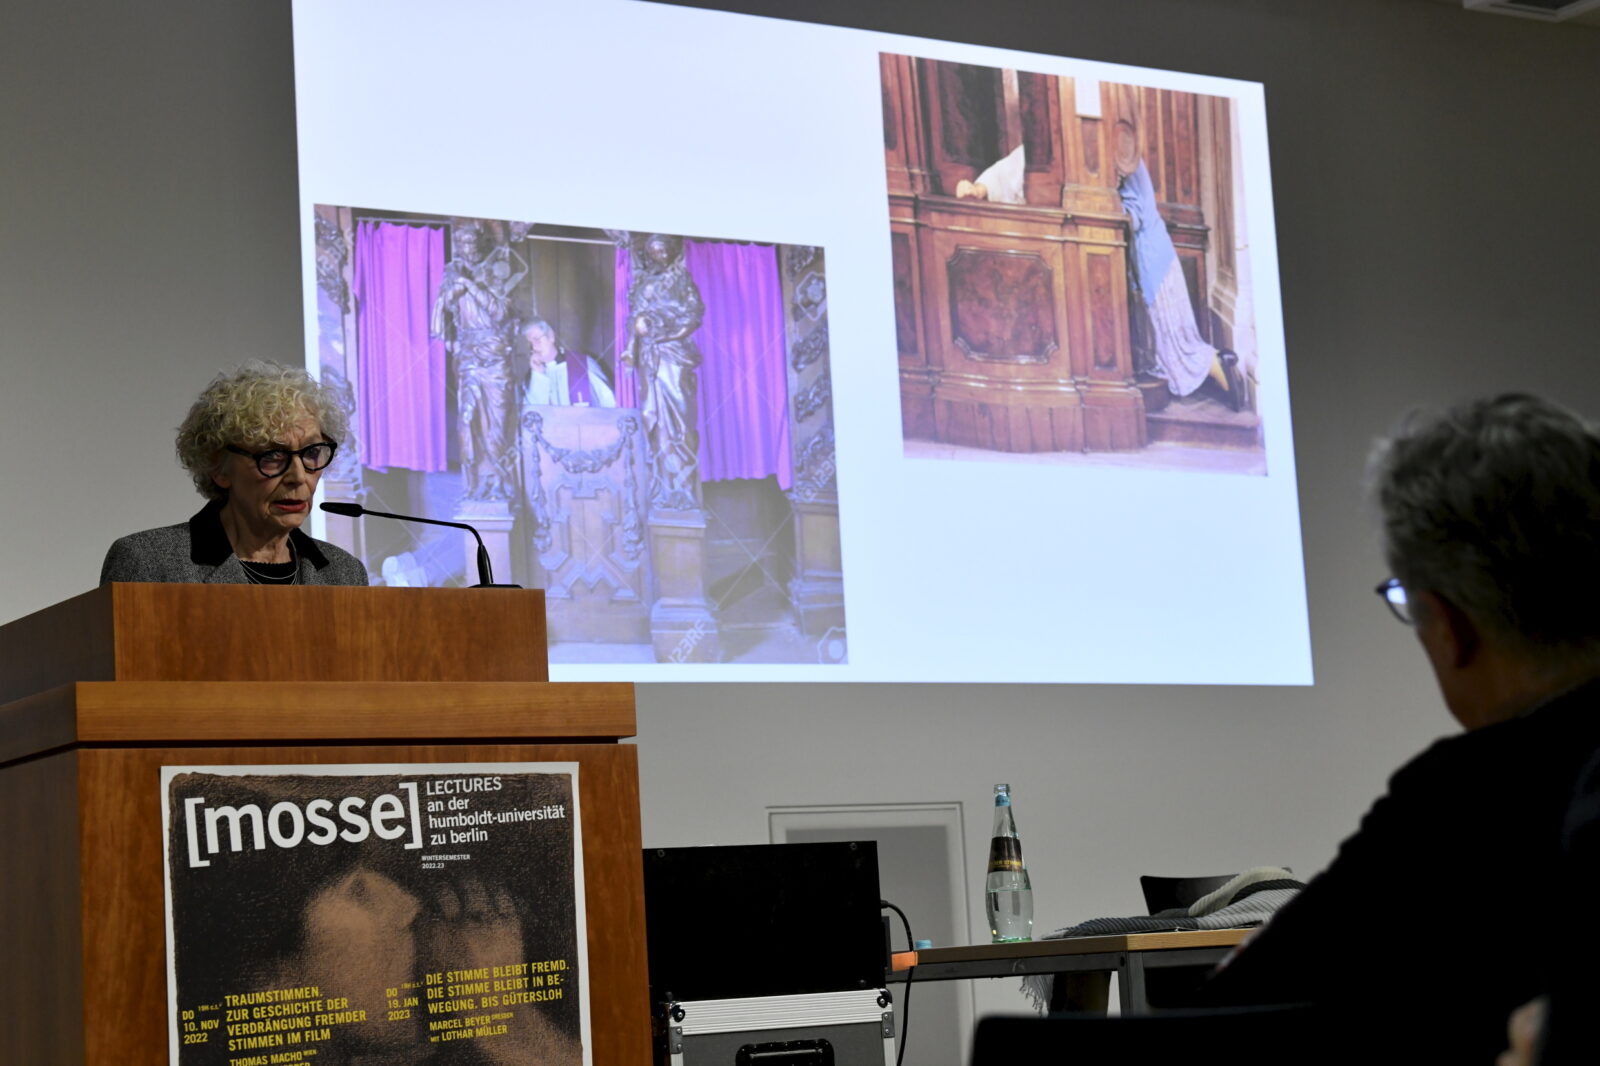
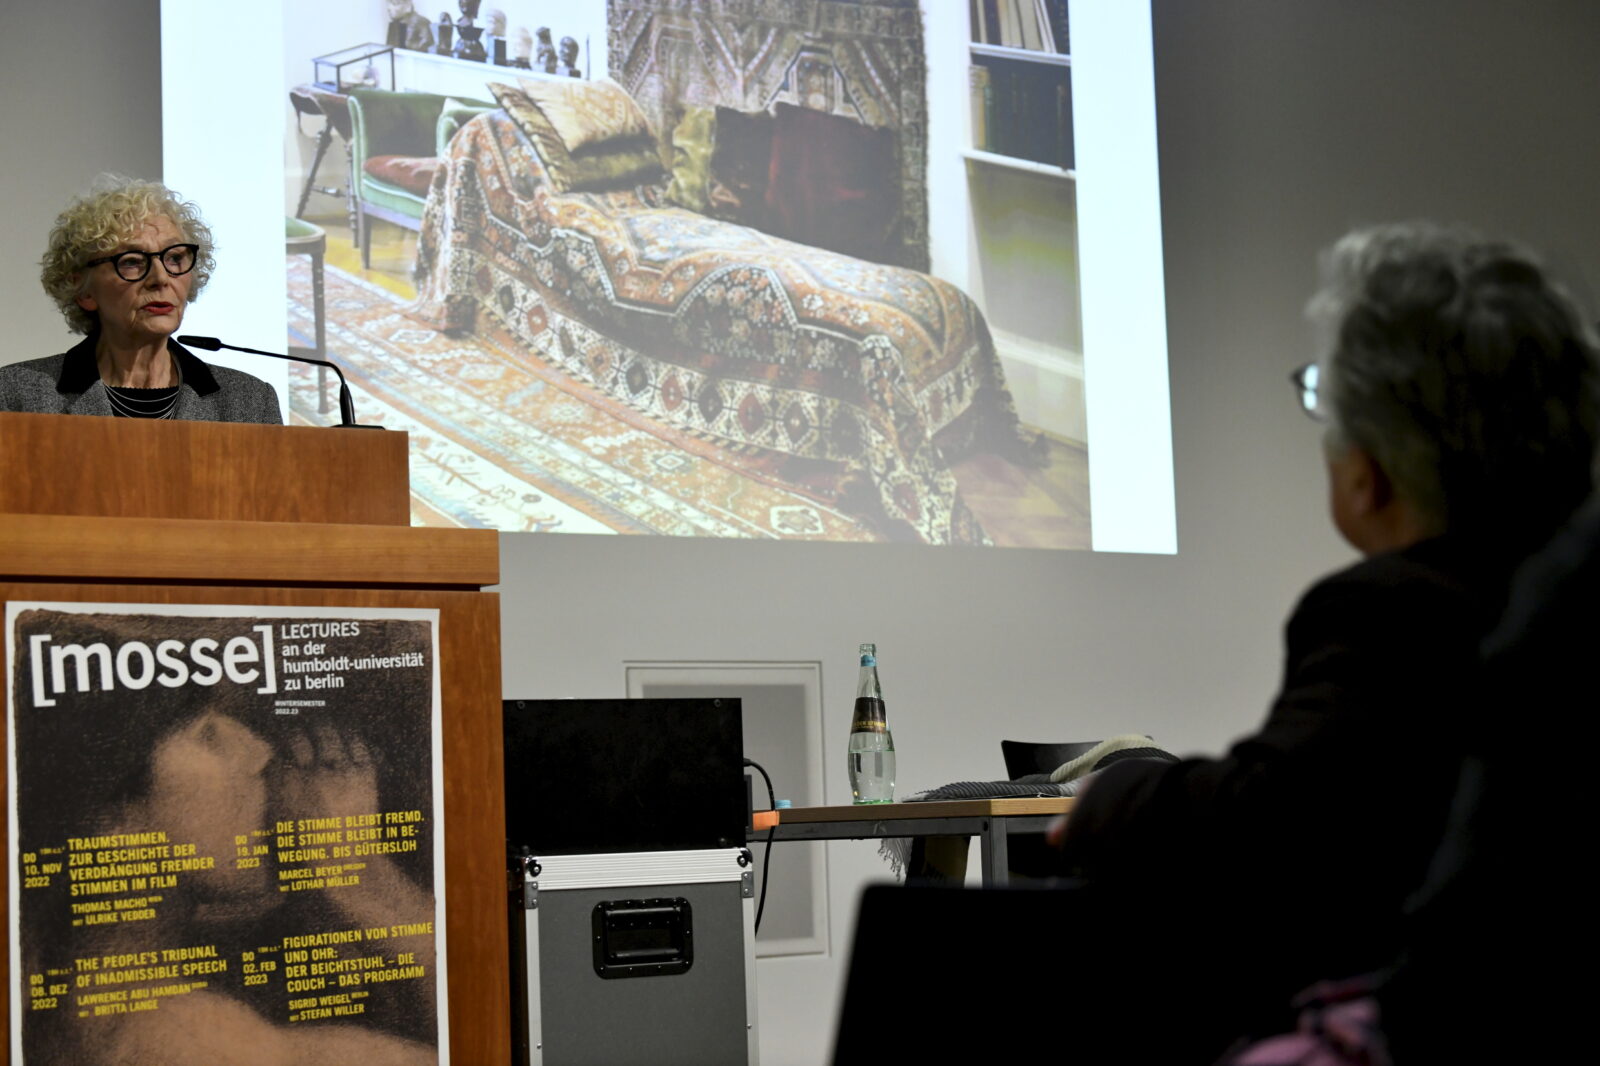
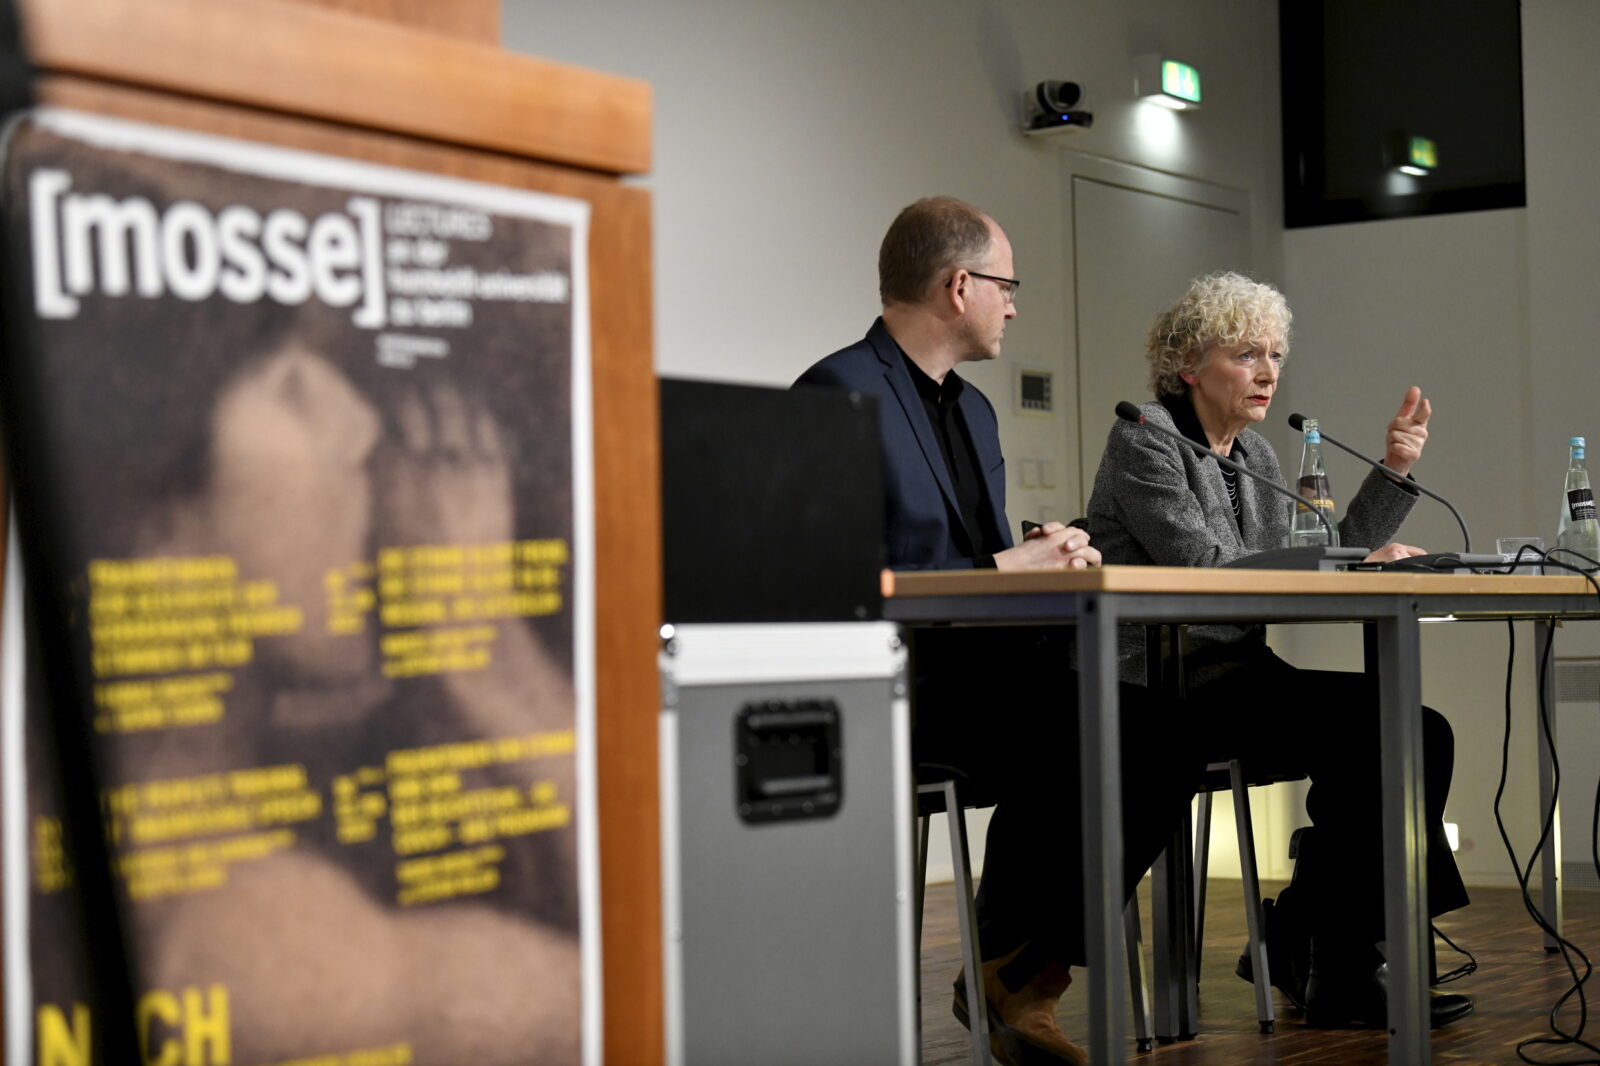
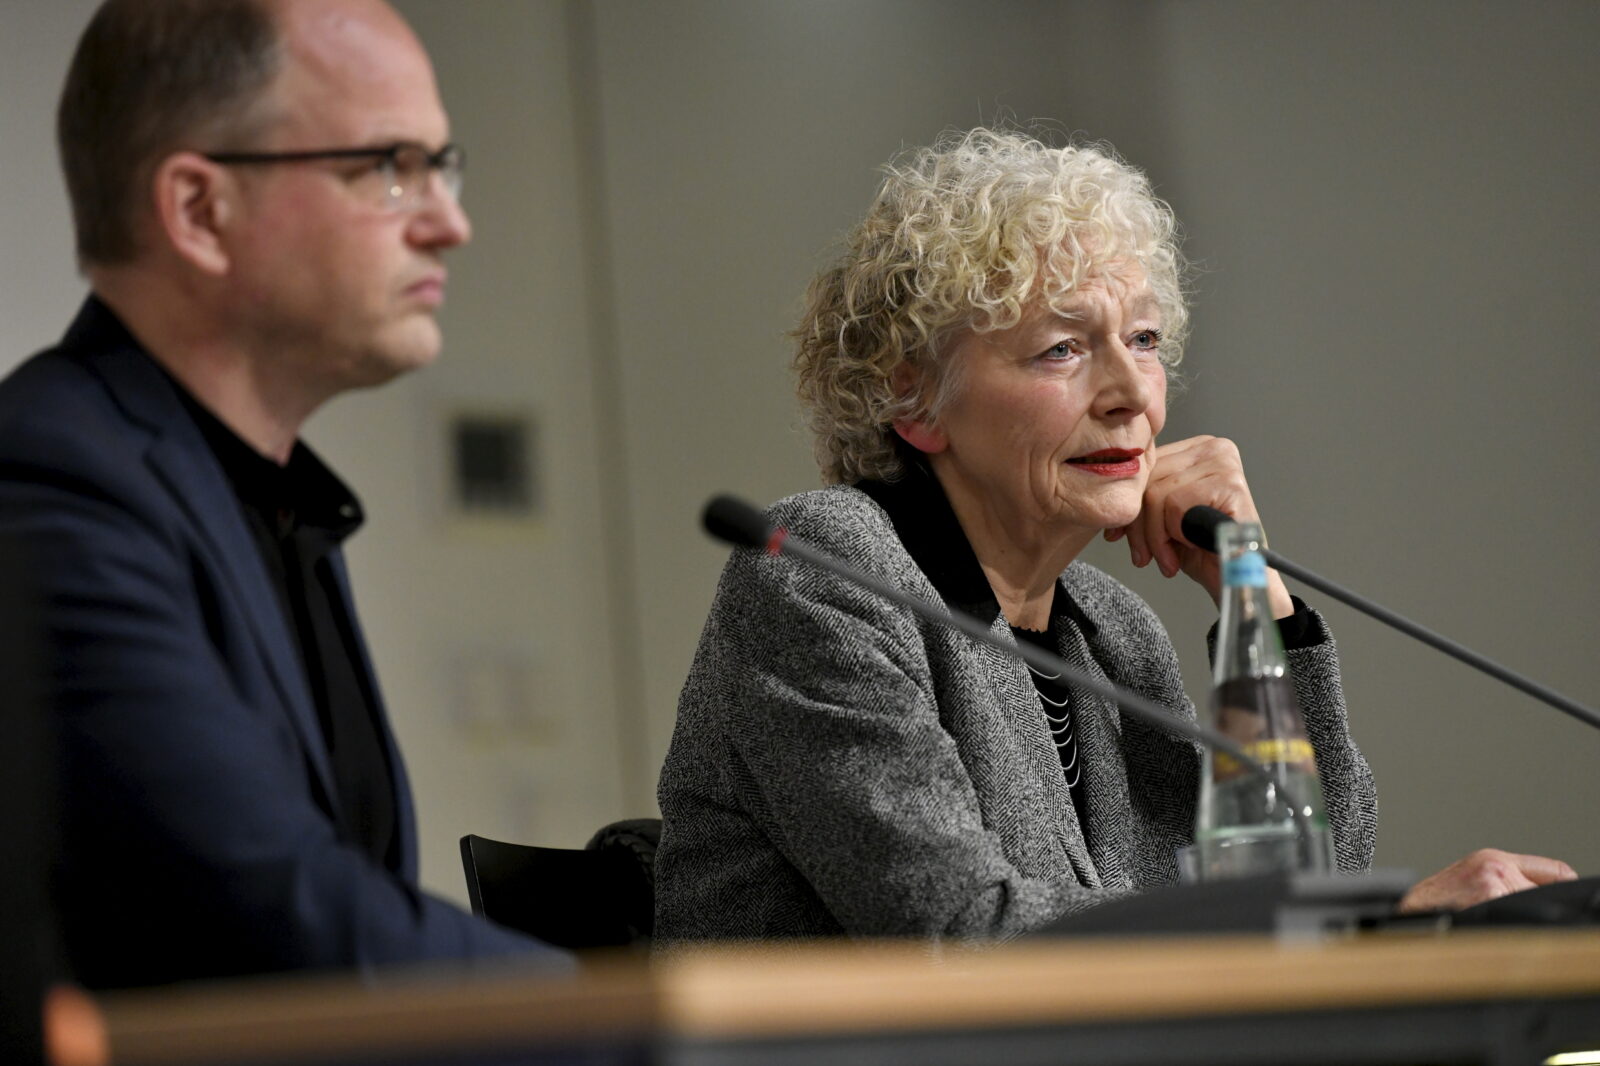
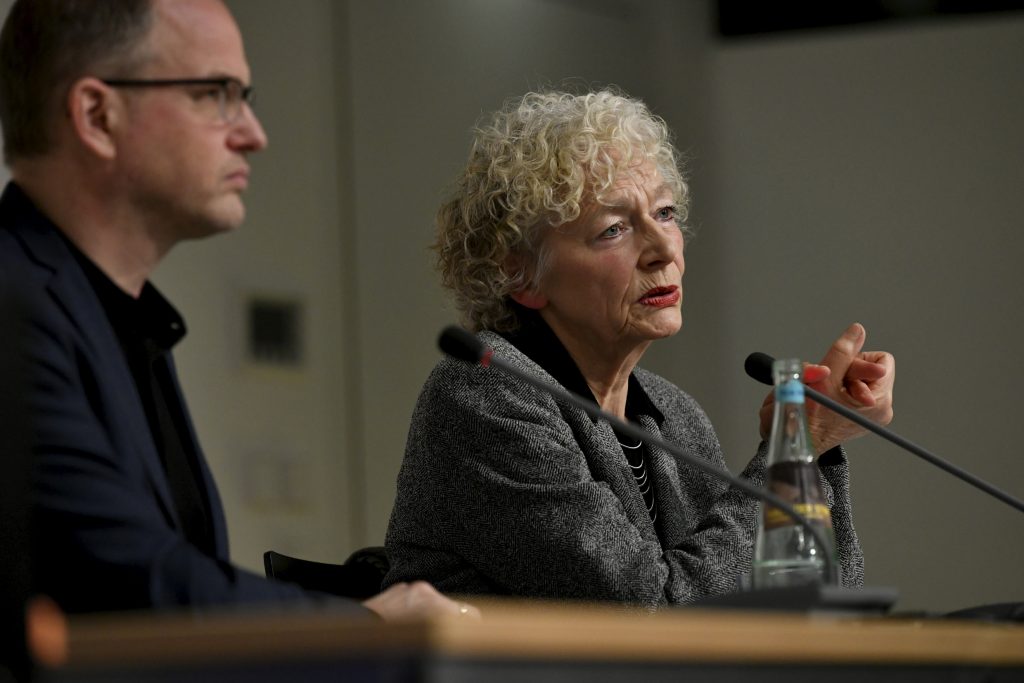
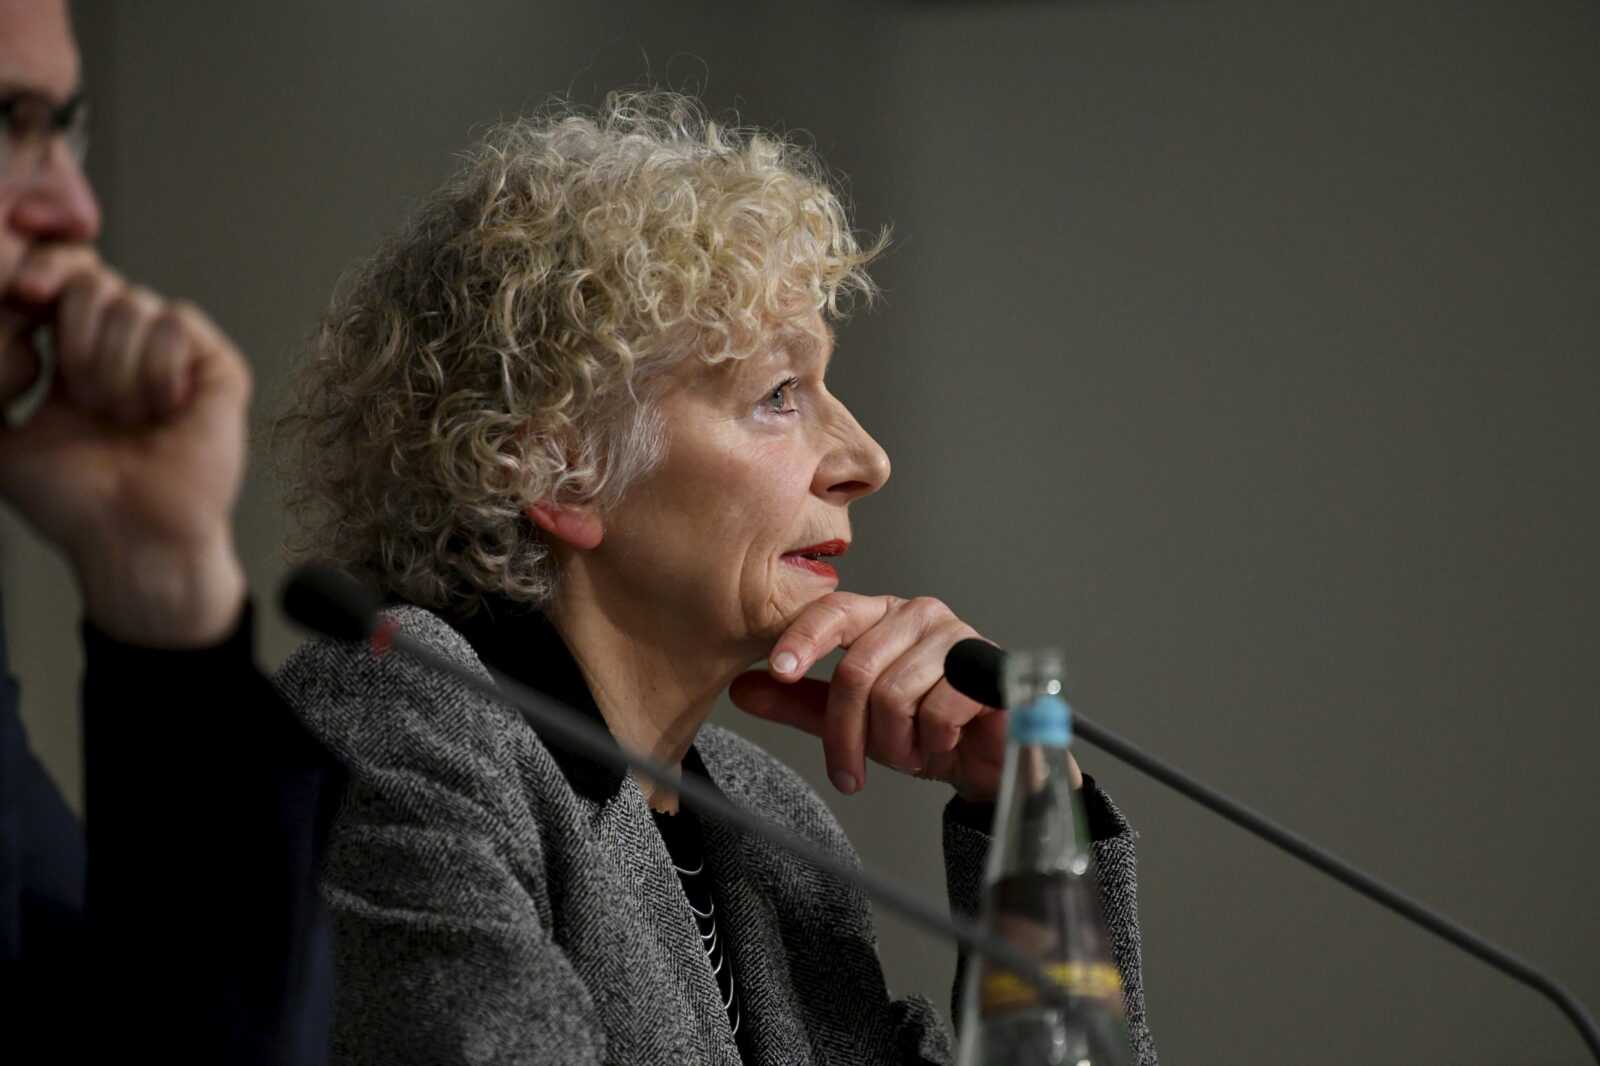
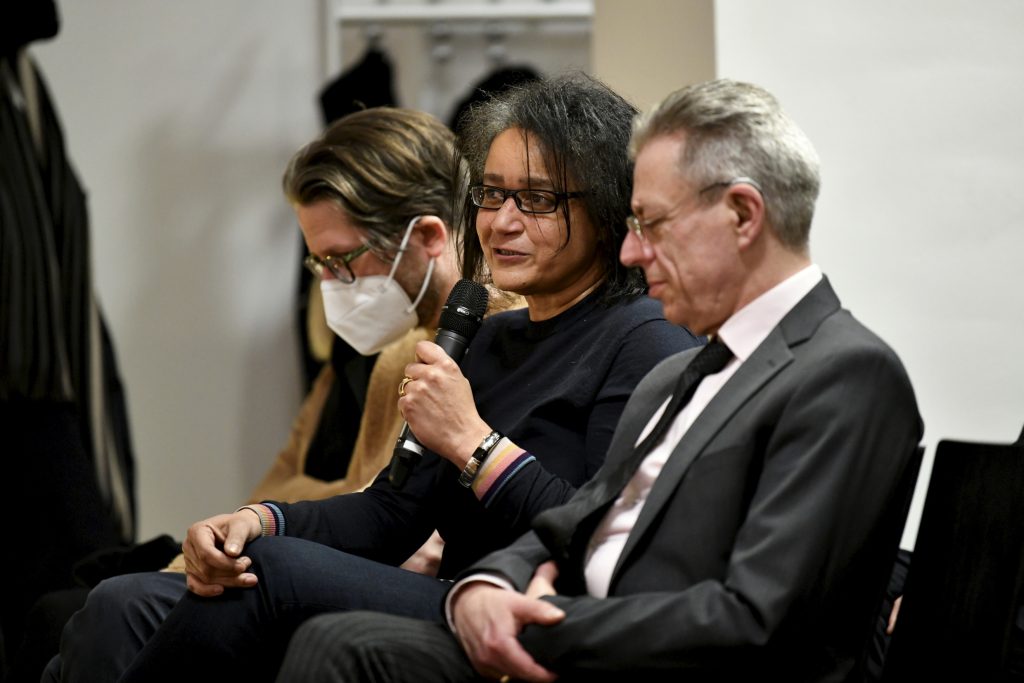
Photo credit: Niels Leiser for the Mosse Lectures
Sigrid Weigel: An expert in literature, cultural theory, and intellectual history. She has taught at Hamburg, Zürich, Berlin, and Princeton. She is the author of over a dozen books, as well as several edited volumes. In 2026 she was awarded the Aby Warburg Prize of the City of Hamburg.
Stefan Willer has occupied the position of Professor for modern German literature at Humboldt University, Berlin, since 2018. From 2014-2018 he was Professor for Cultural Research at Humboldt. His specialties include literary history, cultural history, and the intersection between music and literature. He has served as visiting professor or lecturer at Ludwig-Maximilians-Universität München, the Technische Universität Berlin, Stanford University, Columbia University, and the École des hautes études en sciences sociales, among others. He is the author of Poetik der Etymologie. Texturen sprachlichen Wissens in der Romantik (2003) and Erbfälle. Theorie und Praxis kultureller Übertragung in der Moderne 2014), as well as editor of several volumes.